- 爱又爱科技
- 2026-01-22 11:18:54
2026 年 1 月 22 日,千问 Qwen 正式宣布开源重磅语音生成产品 ——Qwen3-TTS 全家桶。该系列模型全面覆盖音色克隆、音色创造、超高质量拟人化语音生成及自然语言驱动的语音控制能力,凭借创新技术架构实现 “高速、高保真、高可控” 的语音生成体验,已在 Github、ModelScope、HuggingFace 三大平台同步开放,为全球开发者与用户提供一站式语音生成解决方案。
核心亮点:四大技术突破重构语音生成体验
1. 超强语音表征:无损保留原声特征
Qwen3-TTS 搭载自研Qwen3-TTS-Tokenizer-12Hz多码本语音编码器,可实现语音信号的高效声学压缩与高维语义建模,不仅完整保留副语言信息(语气、情感)及声学环境特征,还能通过轻量级非 DiT 架构达成高保真语音还原,在感知语音质量评估(PESQ)、短时客观可懂度(STOI)等关键指标上均达到 SOTA 水平。
2. 端到端架构:规避级联误差
采用离散多码本 LM 架构,实现语音全信息端到端建模,彻底解决传统 LM+DiT 方案的信息瓶颈与级联误差问题,大幅提升模型通用性、生成效率与效果上限,无需复杂链路即可输出高质量语音。
3. 极致低延迟:97ms 实现实时交互
创新Dual-Track 混合流式生成架构让单模型同时兼容流式与非流式生成,输入单字即可输出音频首包,端到端合成延迟低至 97ms,满足实时对话、直播互动等对延迟要求严苛的场景。
4. 智能语音控制:“所想即所听”
支持自然语言指令驱动的多维声学属性调控(音色、情感、韵律等),并深度融合文本语义理解,可根据内容自适应调整语气、节奏与情感表达,实现拟人化程度极高的语音生成,同时对输入文本噪声的鲁棒性显著提升。
技术架构解析:双轨建模 + 多码本设计
Qwen3-TTS 的核心技术优势源于两大创新设计:
多码本语音编码:自研 Tokenizer 实现高效压缩与强表征,在 LibriSpeech test-clean set 中,宽带 PESQ 达 3.21、窄带 PESQ 达 3.68,STOI 达 0.96、UTMOS 达 4.16,说话人相似度高达 0.95,近乎无损保留说话人信息;
Dual-Track 双轨建模:创新混合流式生成方案,兼顾流式实时输出与非流式高质量生成,首包音频仅需等待一个字符,平衡速度与效果。
性能表现:多项任务达成 SOTA 数据亮眼
Qwen3-TTS 在音色创造、控制、克隆三大核心任务中全面超越同类模型,实测数据如下:
音色创造:Qwen3-TTS-VoiceDesign 在 InstructTTS-Eval 中,指令遵循能力与生成表现力整体超越 MiniMax-Voice-Design 闭源模型,大幅领先其他开源方案;
音色控制:Qwen3-TTS-Instruct 支持单人多语言泛化,平均词错率仅 2.34%;保持音色的风格控制得分为 75.4%,可一次性合成 10 分钟长语音,中英词错率分别低至 2.36%、2.81%;
音色克隆:在 Seed-tts-eval、TTS multilingual test set 等权威评测中,中英文克隆语音稳定性超越 MiniMax、SeedTTS 等竞品,10 个语项平均词错率 1.835%、说话人相似度 0.789,跨语种克隆能力位居 SOTA。
开源资源与模型选择:双尺寸适配多元需求
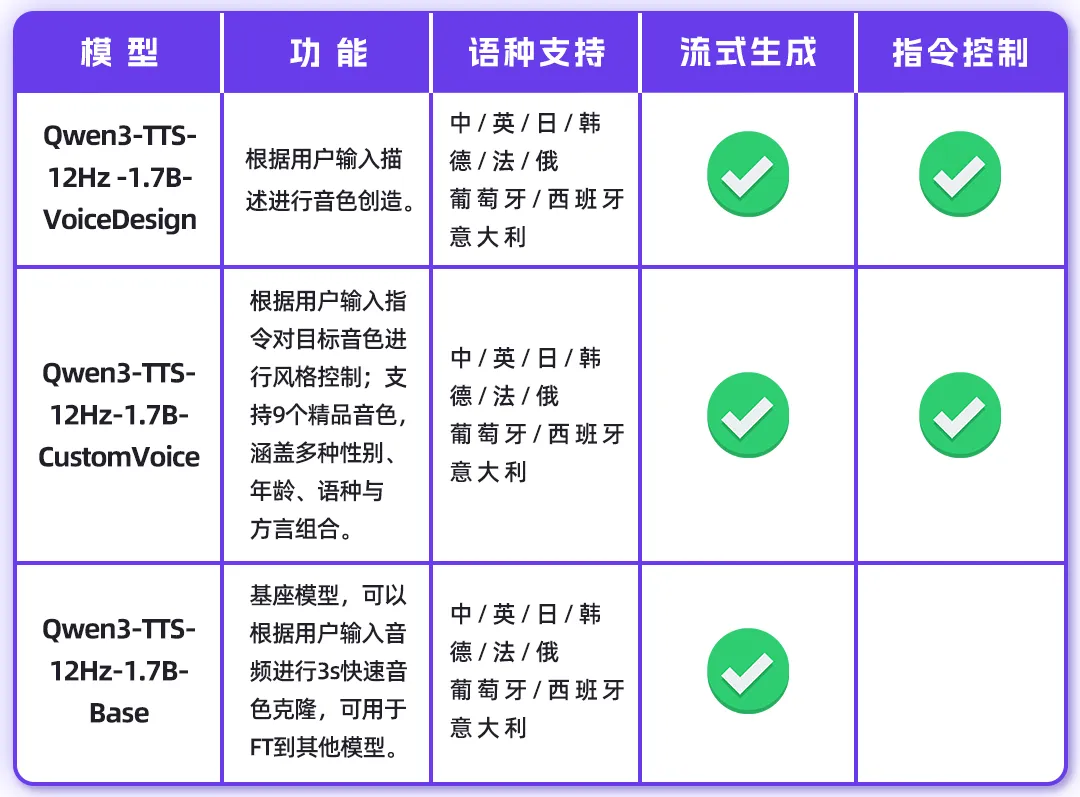
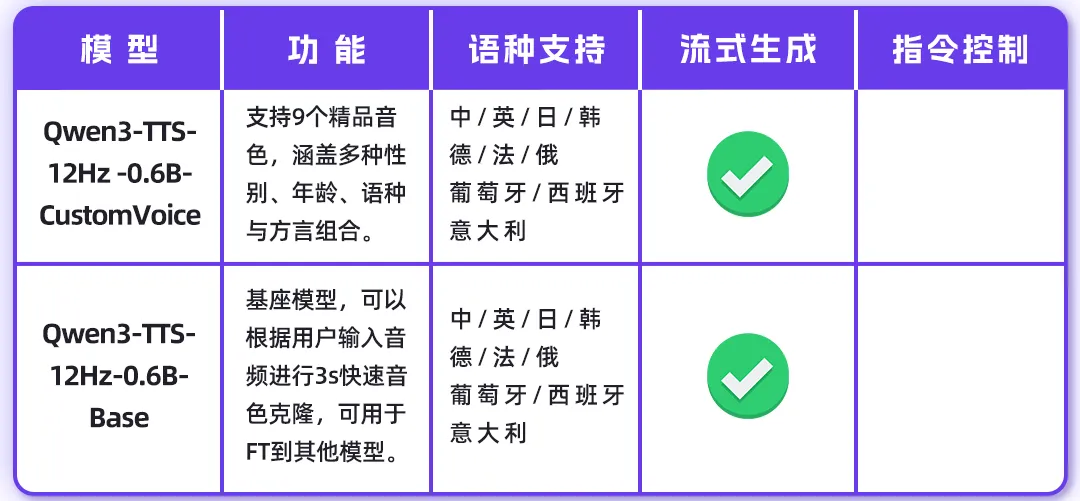
本次开源的 Qwen3-TTS 全家桶包含两种尺寸模型,满足不同场景需求:
1.7B 模型:极致性能取向,具备最强的语音控制与生成能力,适合对效果要求严苛的生产环境;
0.6B 模型:性能与效率均衡,轻量化设计适配端侧部署或资源受限场景。
用户可通过以下平台直接体验或下载模型:
ModelScope:https://www.modelscope.cn/collections/Qwen/Qwen3-TTS
HuggingFace:https://huggingface.co/collections/Qwen/qwen3-tts
Github:https://github.com/QwenLM/Qwen3-TTS
应用场景展望:覆盖全球化多场景需求
Qwen3-TTS 支持中文、英文、日语、韩语、德语等10 种主流语言及多种方言音色,可广泛应用于:
实时交互场景:智能客服、语音助手、直播互动等(低延迟特性适配);
内容创作场景:视频配音、有声书制作、多角色对话生成(音色创造与克隆能力);
全球化应用:跨境电商播报、多语言课程录制、国际会议同传辅助(多语种支持);
个性化需求:定制化语音包、无障碍辅助工具、虚拟人语音驱动等。
Qwen3-TTS 的开源不仅为开发者提供了高性能、全功能的语音生成工具,更推动了语音 AI 技术的普惠化发展。未来,千问 Qwen 团队将持续迭代模型能力,进一步拓展语音生成的应用边界。
最新资讯