- 管理员
- 2026-02-09 09:58:19
智东西2月6日报道,今天,就在Claude发布Opus 4.6后的几分钟,OpenAI也推出了自家的最新编程模型:GPT-5.3-Codex。OpenAI号称,这是世界上最强大的智能体(Agentic)编程模型。


▲GPT-5.3-Codex打造的PPT(图源:OpenAI)

▲Frontier打造的Agent(图源:OpenAI)

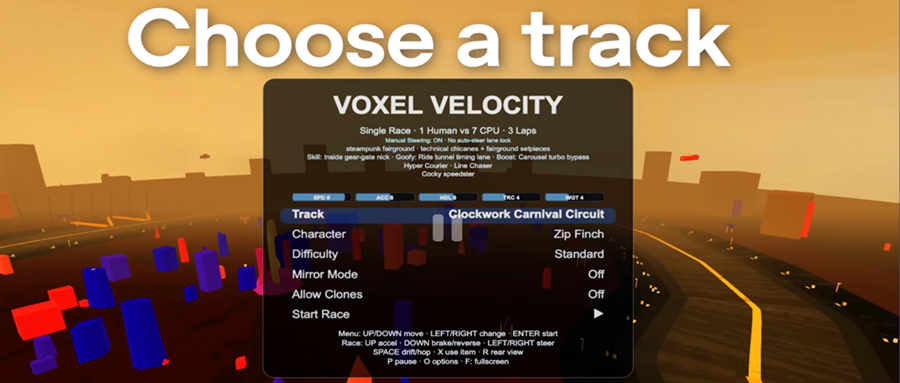
例如,在构建一项名为“Quiet KPI”的服务的网站首页时,GPT-5.3-Codex可以自动将年付方案展示为折扣后的月价,还会自动生成包含三条不同用户评价的轮播组件,而不是仅呈现单条内容。整体页面因此显得更加完整、更加接近可直接上线的产品。 程序员、设计师、产品经理和数据科学家的工作远不止写代码。GPT-5.3-Codex从设计之初就支持整个软件生命周期中的工作,包括调试、部署、监控、编写PRD、编辑文档、用户研究、测试、指标分析、以及更多专业工作。 在使用类似GDPval的自定义技能后,GPT-5.3-Codex在GDPval(一个衡量44种职业中明确知识型任务的评估)上达到了与GPT-5.2相当的水平。 在考察模型计算机使用能力的OSWorld-Verified中,人类平均得分约为72%,而GPT-5.3-Codex达到了64.7%。GPT-5.3-Codex在该评测中表现显著优于以往的GPT模型。 随着GPT-5.3-Codex的发布,Codex还提供了一个新的设置选项“工作中可引导”。开启后,GPT-5.3-Codex会在工作过程中频繁更新关键决策和进展,支持实时对话、提问、讨论方案,并在执行期间持续解释其思路并提供反馈。这让人类用户可以更高效地指挥和监督多个Agent。 OpenAI称,得益于基础设施和推理栈的改进,Codex用户的GPT-5.3-Codex整体速度提升了25%。该模型开发过程中,OpenAI与英伟达展开了合作,基于GB200 NVL72系统设计、训练和部署。


最新资讯